IA documentaire
Diot-Siaci
Relier chaque réponse à la clause du contrat qui la justifie.
Ma contribution Diot-Siaci
Chaque réponse,sa clause.
Parcourir les projets
Une réponse. Sa source.
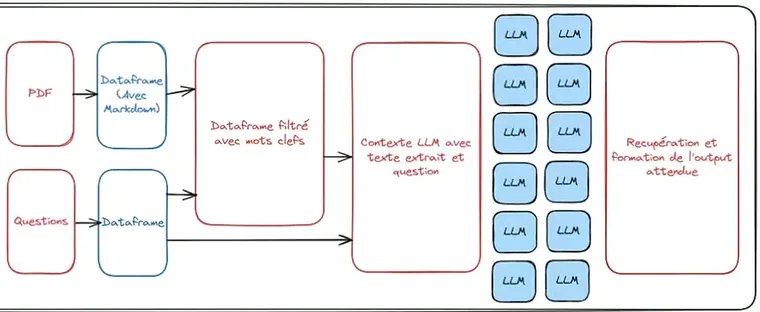
Un pipeline documentaire sélectionne le contexte, interroge le modèle et relie la réponse au passage d’origine pour qu’un humain la vérifie.
Du PDF au texte positionné.
Le document est converti en Markdown en conservant sa structure et la position des éléments, pour revenir ensuite à la page et au passage d’origine.
Retrouver le contexte utile.
TF-IDF, BM25, expressions régulières et embeddings sont comparés puis combinés pour ne transmettre au modèle que les passages pertinents.
Des appels contrôlés, une preuve à la sortie.
Les appels aux LLM sont parallélisés avec asyncio, leur JSON est vérifié et les erreurs traitées ; les réponses sont exportées et annotées dans le PDF.
Ma contribution
Le besoin
Pour relire un contrat d’assurance, une réponse extraite par un modèle doit pouvoir être confrontée au document. Pendant mon stage R&D chez Diot-Siaci, j’ai fait évoluer une exploration en notebooks vers une preuve de concept en Python avec une API et des sorties destinées à la vérification humaine.
Du contrat PDF au passage annoté
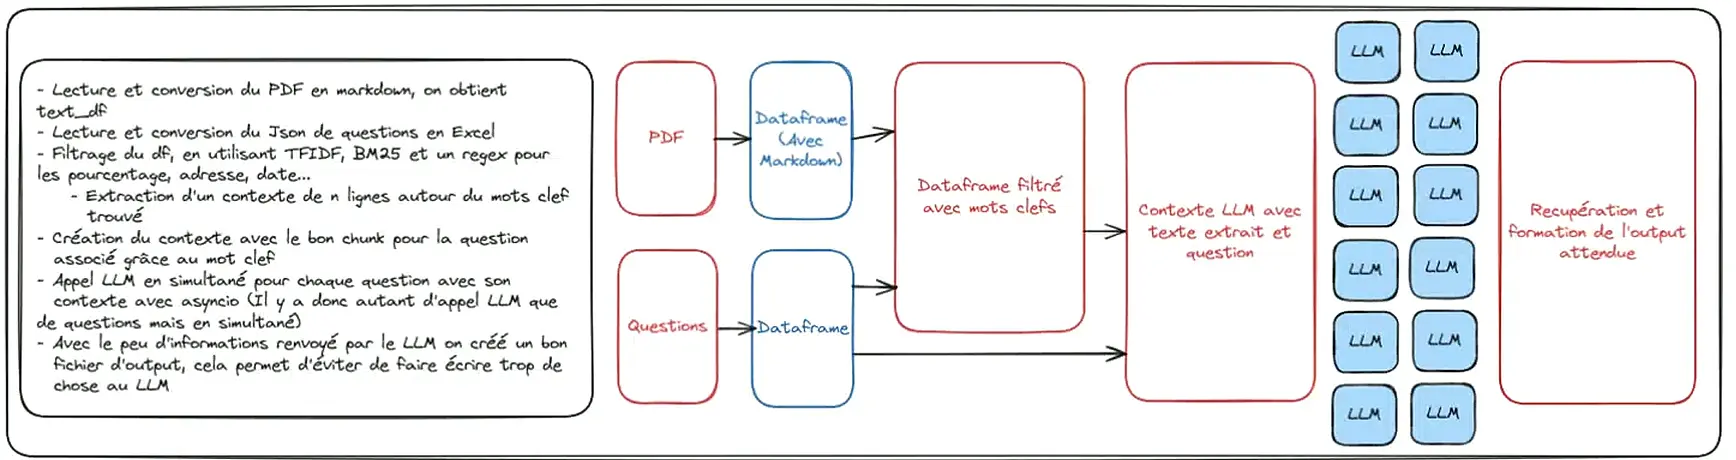
La conversion produit deux éléments qui se rejoignent à la fin. Le texte sert à trouver les extraits utiles et à interroger le modèle. Les positions de page permettent ensuite de reporter l’extrait dans le PDF. Le relecteur peut partir de la réponse exportée et retrouver son passage dans le contrat.
Comment fonctionne le flux
- Préparer le PDF
La conversion produit du Markdown et conserve les positions dans les pages.
- Chercher le contexte
La recherche sélectionne les extraits liés à chaque question.
- Interroger et valider
Les appels au modèle sont parallélisés et leurs réponses JSON contrôlées.
- Exporter et annoter
Les résultats sont exportés et les passages sources repérés dans le PDF.
Réalisations
Rendre le PDF exploitable
J’ai travaillé sur la conversion du PDF en Markdown en conservant la hiérarchie du texte et la position des éléments. Ces repères permettent de retrouver le passage dans sa page d’origine.
Sélectionner les passages pour chaque question
J’ai comparé TF-IDF, BM25, les expressions régulières et les embeddings pour repérer le contexte utile. La sélection transmet au modèle les extraits pertinents pour la question posée.
Paralléliser et contrôler les réponses du modèle
J’ai structuré l’exécution des questions avec asyncio. Le traitement vérifie le format JSON et gère les erreurs avant de remettre les réponses à l’étape de restitution.
Restituer les résultats avec leurs sources
J’ai travaillé sur les sorties JSON et Excel ainsi que sur l’annotation du PDF source. Le résultat structuré sert à relire les réponses, et le document permet de vérifier les passages sur lesquels elles s’appuient.
 Les Abeilles de Victoire